Den Weg zur AGI trocken dokumentieren
Mein erstes öffentliches Astro-Projekt: ein AGI-Tracker mit Dashboard, wöchentlichem Briefing und einem Composite Score aus acht Benchmarks. Warum ich das gebaut habe, wie der Score zustande kommt und was die Zahlen für IT-Abteilungen heißen.
agi.jetzt entstand im Mai an einem Abend kurz nach 22 Uhr. Ich saß vor meiner Domain-Liste und sah die ungenutzte Domain drin liegen. Vor zwei Jahren registriert, weil ich dachte ich mache mal was damit. Dann lag sie da und niemand sprach drüber. Statt sie auslaufen zu lassen kam mir die Frage: Was wenn ich den Weg zur AGI trocken dokumentiere, als datengetriebenes Nachschlagewerk?
Drei Wochen später ging die Seite online. Astro 5, Tailwind 4, eine Three.js-Visualisierung im Hero, ein wöchentliches Briefing, ein Dashboard mit 17 Widgets und ein Composite Score aus acht Benchmarks. Es war mein erstes komplettes öffentliches Astro-Projekt, dazu habe ich Three.js und GSAP zum ersten Mal im vollen Scope einer Site eingesetzt. Online ist sie seit Mai, dokumentiert wird sie hier erst jetzt, weil ich noch ein paar Bauteile dazu nehmen wollte bevor ich drüber schreibe.
Visuell zitiert die Seite bewusst die Codes der aktuellen AI-Design-Welle: Serif-Display-Typo mit Italic-Akzenten, Lila als Signature-Color, das Neural-Mesh als Hero-Motiv. Wer aktuell durch Anthropic-, Mistral-, OpenAI- oder Perplexity-Sites scrollt, sieht dieses Vokabular überall. Es ist im Mai 2026 das visuelle Code-Wort für “hier geht es um KI”. Auf agi.jetzt ist das Programm. Wenn KI über KI berichtet, soll man das im Design sofort lesen. Der Human-in-the-Loop-Twist drumherum wird im Prozess sichtbar gemacht und ist im Look kein Thema.
Diese Notiz beschreibt, was ich beim Bauen gelernt habe, methodisch und technisch, und was die Zahlen für IT-Abteilungen heißen.
Warum ein weiterer KI-Tracker
Die deutsche AGI-Diskussion pendelt zwischen zwei Polen. Auf der einen Seite Hype-Zyklus, jedes Modell-Release ist “der nächste große Sprung”, jedes Feature ein Game Changer. Auf der anderen Seite Doom-Pamphlet, KI nimmt alle Jobs, Skynet ist nächstes Jahr live. Beides hilft IT-Leitern und Operatoren in der Praxis nicht weiter.
Was fehlt, ist eine ehrliche Bestandsaufnahme. Was können die Modelle heute, was können sie nicht, und wie groß ist der Rest-Gap zu dem was man “menschliches Niveau” nennen könnte. Genau das versucht agi.jetzt zu liefern. Kein Manifest, keine Prognose, kein Investment-Pitch. Ein laufendes Notizbuch mit Score, Briefing und Deep-Dives.
Nebenbei wollte ich Astro, Three.js und GSAP im Scope einer ganzen Site lernen. Das war ehrlich gesagt die zweite Motivation. Wer ein Lernprojekt sucht und einen Kontext braucht, der über Todo-App hinausgeht, findet in einer Themen-Site mit echten Daten einen guten Aufhänger.
Acht Dimensionen, ein Score
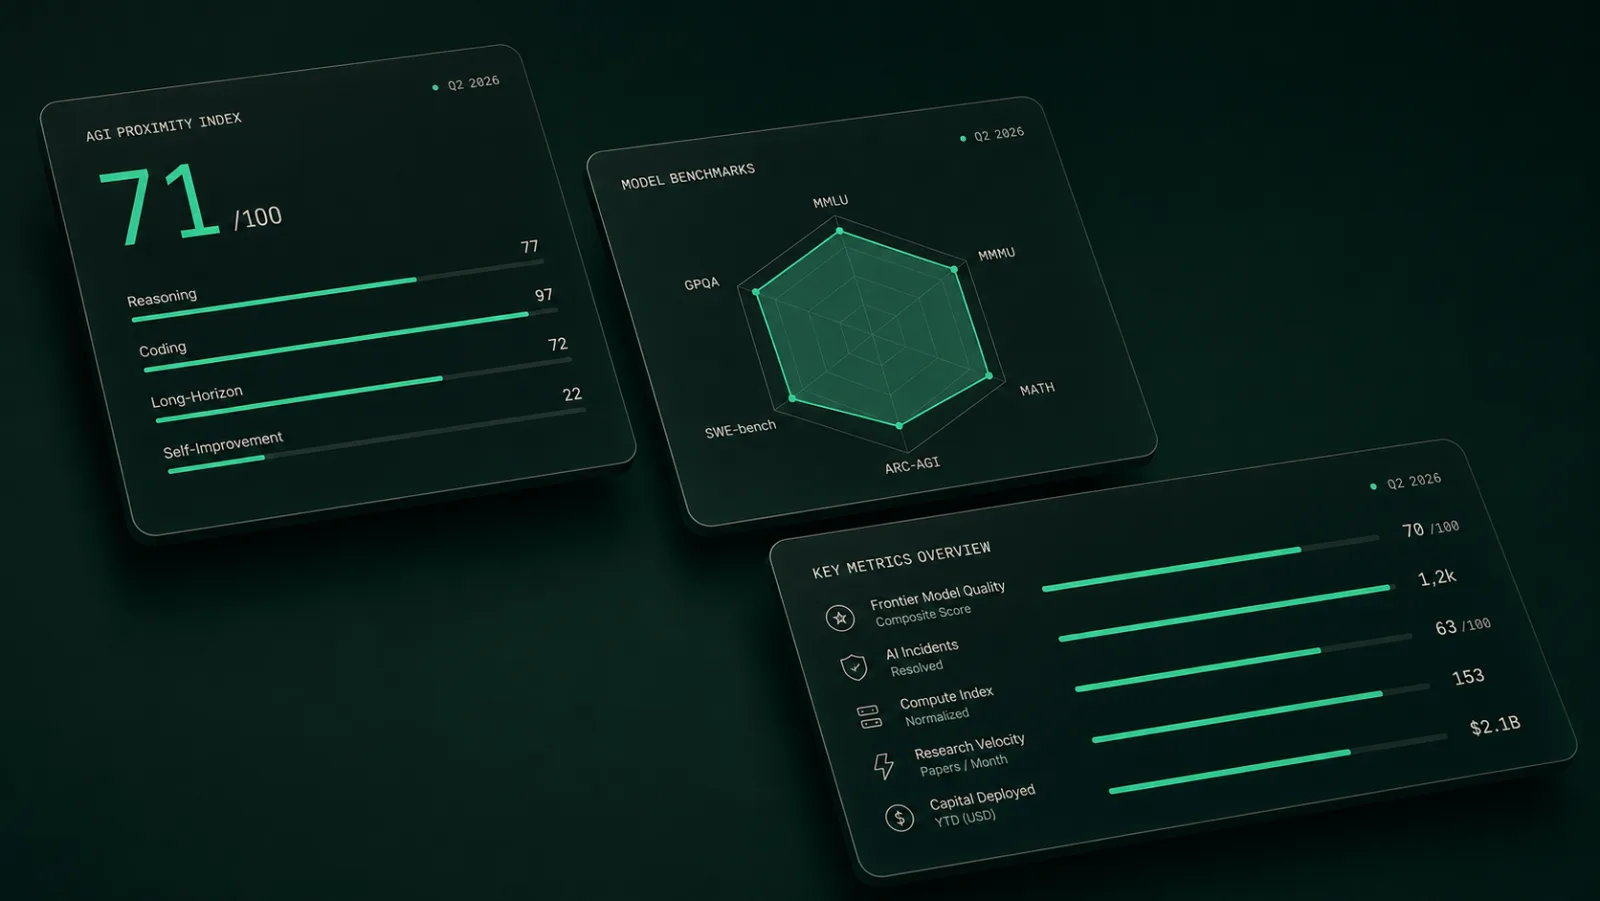
Der Kern der Seite ist der AGI Proximity Index. Stand Q2 2026 liegt er bei 71%. Er setzt sich aus acht Benchmark-Lücken zusammen, jede gewichtet, alle aus öffentlichen Quellen:
| Dimension | Gewicht | Aktueller Gap | Benchmark |
|---|---|---|---|
| Long-Horizon Agency | 20% | 72% | METR 24h Tasks |
| Abstract Reasoning | 15% | 77% | ARC-AGI-2 |
| Self-Improvement / RSI | 15% | 22% | METR RE-Bench |
| Coding Agency | 12% | 97% | SWE-bench Verified |
| Tool Use & Autonomie | 12% | gesättigt | OSWorld |
| Multimodal Understanding | 10% | 99% | MMMU |
| Expert Knowledge | 8% | gesättigt | GPQA Diamond |
| Advanced Math | 8% | gesättigt | MATH + AIME |
Wichtig ist die Mittelwert-Logik. Der Composite ist ein gewichtetes geometrisches Mittel, kein arithmetisches. Das war eine bewusste Entscheidung. Ein arithmetisches Mittel würde Kompensation erlauben, frei nach dem Motto: “Multimodal liegt bei 99%, also kann Self-Improvement bei 22% bleiben, ist ja im Durchschnitt okay”. Das wäre für AGI falsch. AGI braucht alle Fähigkeiten gleichzeitig. Ein guter Durchschnitt reicht nicht.
Das geometrische Mittel bestraft Extreme. Wenn eine einzelne Dimension sehr niedrig ist, drückt sie den Gesamtscore überproportional. Heißt konkret: solange Self-Improvement bei 22% steht und Long-Horizon bei 72%, kann der Score nicht in den 90er-Bereich klettern, egal wie viele andere Dimensionen sich sättigen.
Wer sich die Zahlen ansieht, erkennt ein klares Muster. Drei Dimensionen sind faktisch gelöst: Expert Knowledge auf GPQA Diamond, Advanced Math auf MATH/AIME und Tool Use auf OSWorld. Frontier-Modelle übertreffen menschliche Experten reproduzierbar. Multimodal Understanding ist mit 99% Gap nah dran. Coding Agency liegt mit SWE-bench Verified bei 87.6%, was zum ersten Mal nah am Senior-Engineer-Niveau für isolierte Tasks ist.
Die echten Engpässe heißen Long-Horizon Agency und Self-Improvement. Long-Horizon misst, ob ein Agent eine Task-Kette über 24 Stunden und mehr autonom durchziehen kann. METR-Ergebnisse zeigen, dass Agents in Stunden-Fenstern stabil funktionieren, aber über mehrere Tage den Fokus verlieren. Self-Improvement misst, ob ein Modell KI-Forschung automatisieren kann, der berühmte Recursive-Self-Improvement-Loop. Hier liegt DeepMinds AlphaEvolve-2 bei 22%.
Genau das ist der Punkt. Die Lücke liegt nicht mehr bei “kann das Modell X”. Sie liegt bei “kann es X selbständig über Wochen liefern”. Das ist ein qualitativ anderes Problem als Benchmark-Scores zu pushen.
17 Widgets als Live-Cockpit
Der Proximity Index ist die Headline, aber das Dashboard liefert den Kontext drumherum. 17 Widgets, quartalsweise aktualisiert, alle Werte aus öffentlich verifizierbaren Quellen. Das sind grob fünf Cluster:
| Cluster | Widgets |
|---|---|
| Capability | AGI Proximity Index, Model Benchmarks (Radar), Model Specs (13 Modelle im Vergleich) |
| Geld & Markt | AI Investment Tracker ($524 Mrd seit 2022), Company Leaderboard (Top 15 nach Valuation), Funding Breakdown nach Kategorie |
| Infrastruktur | Compute & GPU Markt (Cloud-Preise, Top Clusters), ArXiv Papers, Trending Topics |
| Society & Workforce | Hiring Trends (128.400 offene Stellen, +62% YoY), Consumer Adoption (ChatGPT WAU, Gemini App MAU) |
| Risk & Regulation | Safety Incidents (487 in 2025), Regulations Tracker (EU AI Act, NIST, China, UK), 12-Monats-Timeline |
Der Anspruch ist nicht Vollständigkeit, sondern Selektion. Ich versuche pro Cluster die zwei oder drei Zahlen zu haben, die ein IT-Leiter im Jahresgespräch braucht, ohne sich 30 Studien durchlesen zu müssen. “Top Clusters” zum Beispiel zeigt vier Datenpunkte: xAI Colossus 2 mit 200k GPUs, Meta Dark Matter 350k, Microsoft/OpenAI 220k, Google DeepMind 180k. Mehr braucht es nicht um die Größenordnung zu greifen.
Was bewusst fehlt: Microsoft-Copilot- oder Salesforce-Einstein-Adoption. Enterprise-Adoption ist im Aggregat fast nicht ehrlich messbar. Vendor-Zahlen sind in der Regel “Seats sold”, nicht “Seats actively used”. Ich nehme nur Konsumenten-Zahlen rein, weil die quartalsweise von OpenAI, Google und Anthropic in Earnings-Calls bestätigt werden. ChatGPT bei 900M WAU, Gemini-App bei 750M MAU, Stand Februar 2026.
Briefing als Human-in-the-Loop-Test
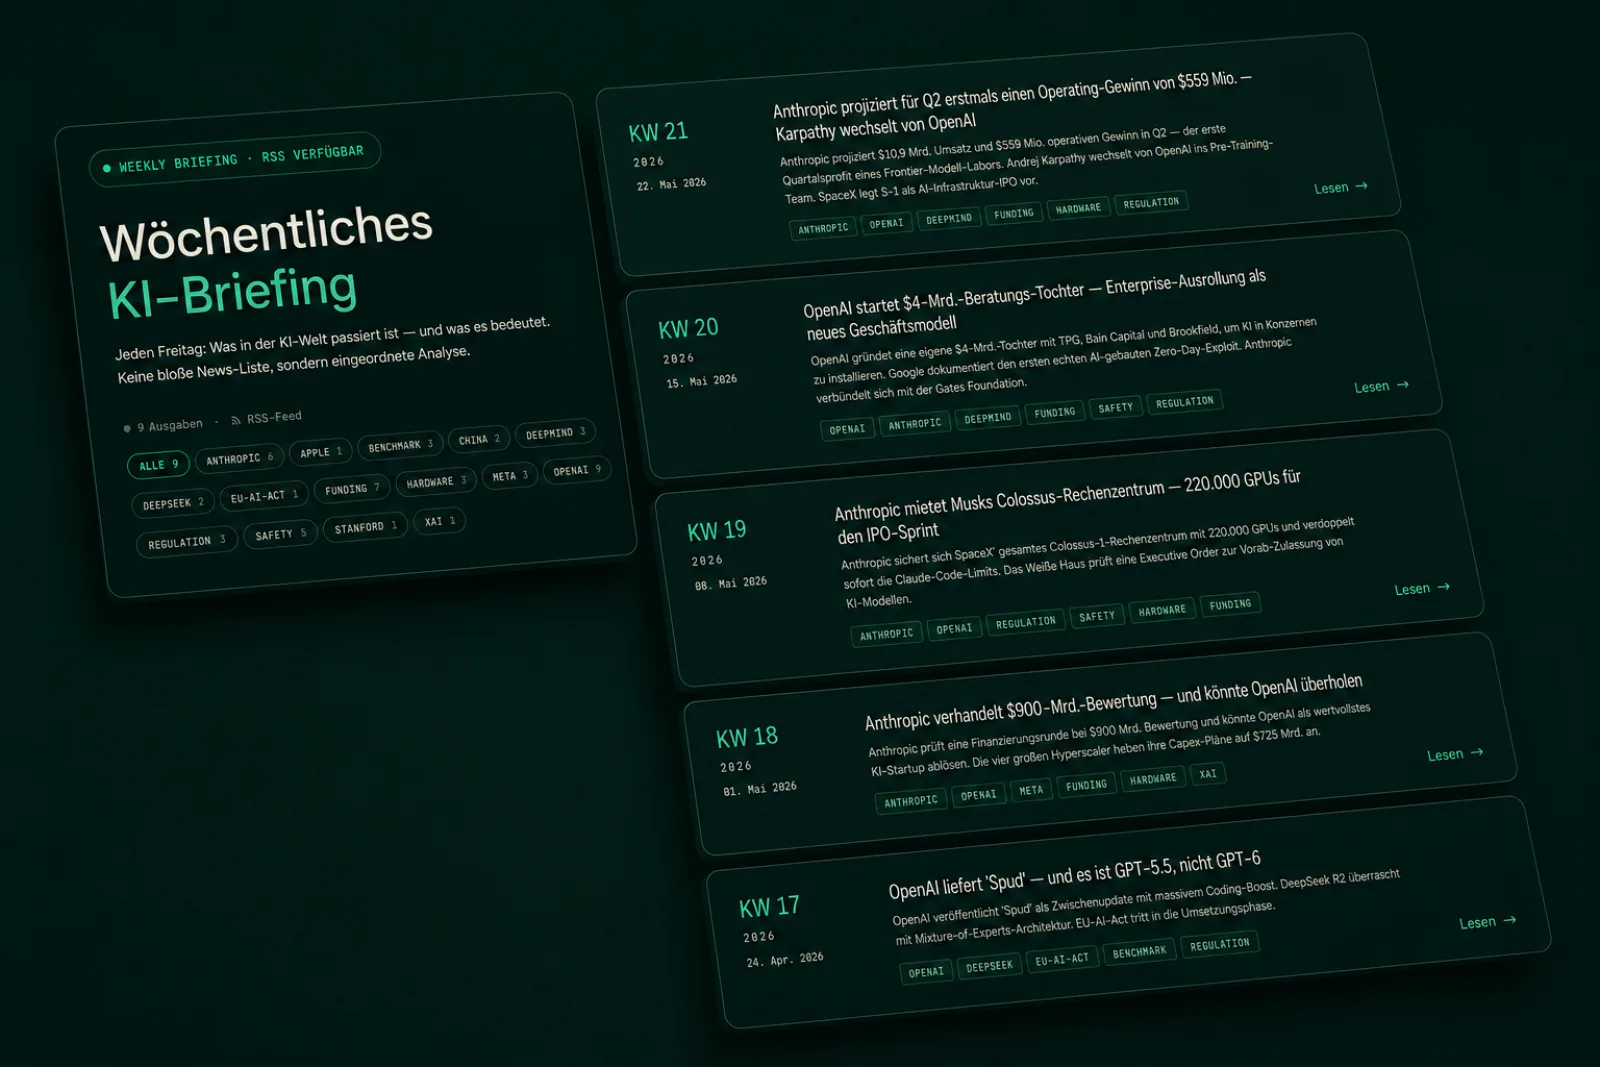
Neben dem Dashboard gibt es das wöchentliche KI-Briefing. Jeden Freitag eine Ausgabe, in KW-Logik geführt. Stand heute mehrere Ausgaben live, RSS-Feed offen, keine Anmeldung.
Das Format ist bewusst kein News-Aggregator. Es gibt eine Story der Woche mit eingeordneter Analyse, eine “Zahl der Woche” mit Kontext, dazu ein paar getaggte News (Anthropic, OpenAI, DeepMind, Funding, Hardware, Regulation). Wer nur Headlines will, ist auf Hacker News besser bedient. Wer wissen will, warum Anthropics $559 Mio. Operating-Gewinn in Q2 ein größeres Signal ist als der nächste OpenAI-Hype, hat hier eine Notiz dazu.
Mechanisch läuft das so: Briefings, Dashboard-Updates und Score-Changes kommen über Claude-Code-Routinen rein, die einen GitHub-PR mit Änderungsvorschlägen schreiben. Ich gehe drüber, kommentiere, lehne ab oder merge. Was am Ende live geht, hat ein Approval von mir. Der Look der Site signalisiert “KI macht das”. Der Workflow stellt sicher, dass am Ende ein Mensch unterschreibt. Beides ist ehrlich.
Was ich in der Praxis sehe, deckt sich mit dem was der Long-Horizon-Score auf dem Dashboard sagt. Ein Agent kann mir die Rohdaten der Woche zuverlässig sammeln, sortieren und einen ersten Entwurf der Story bauen. Was er nicht stabil kann, ist über mehrere Wochen einen konsistenten redaktionellen Bogen zu halten, eine Wochen-zu-Wochen-Verbindung zu erkennen oder zu wissen wann ein Vendor-Statement ein PR-Vehikel ist und wann ein echtes Signal. Diese Bewertungs-Ebene mache ich selbst beim PR-Review. Heute ist das noch ein klarer Vorteil. In 12 Monaten ist es wahrscheinlich eine Frage von Tooling und Memory.
AGI-Modell-Releases sind außerdem genau das Feld, wo eine Halluzination peinlich wäre und sofort gefunden würde. Die Faktencheck-Schwelle bleibt deshalb hoch und der PR-Flow bleibt offen.
Methodik als Designprinzip
Beim Bauen war mir Disziplin in der Methodik wichtig. Drei Regeln waren nicht verhandelbar.
Erstens, jeder Score muss eine externe Primärquelle haben. Keine eigenen Tests, keine internen Schätzungen, keine “ich habe das ChatGPT mal gefragt”-Werte. ARC-Prize, METR, SWE-bench, OSWorld, MMMU, alles publizierte Benchmarks mit veröffentlichten Human-Baselines.
Zweitens, eine Sättigungs-Regel. Wenn ein Benchmark-Gap über drei Quartale in Folge bei mindestens 95% steht, wird automatisch auf den Successor umgestellt. GPQA wird zu Humanity’s Last Exam. MATH wird zu FrontierMath. Damit bleibt der Score eine ehrliche Messung des Rest-Gaps und läuft nicht “fertig”, wenn die alten Benchmarks abgehakt sind.
Drittens, Public-by-default. Alle Daten liegen als Markdown im GitHub-Repo. Wer eine Quelle in Frage stellt, macht ein Issue auf. Wer eine Gewichtung anders sehen will, forkt den Code. Kein Newsletter-Gate, kein Lead-Capture, kein Cookie-Banner.
Was das für IT-Abteilungen heißt
Jetzt der praxisrelevante Teil. Wer Agentic Automation in einer IT-Abteilung plant, sollte sich diese drei Zahlen merken.
Coding Agency bei 87% SWE-bench. Heißt: Junior-Dev-Tasks, isolierte Bugfixes und kleine Refactorings sind realistisch automatisierbar. Architekturentscheidungen, Cross-System-Integrationen und schwer dokumentierte Legacy-Codebases bleiben Senior-Aufgabe. Wer einen “Coding-Agent ersetzt das Team” verkauft, übersieht den 13%-Gap und vor allem, wo der Gap liegt.
Long-Horizon Agency bei 72%. Heißt: Ein Agent kann ein Ticket bearbeiten, eine Recherche durchführen, einen Report schreiben. Was er nicht stabil kann ist ein Projekt über drei Wochen tragen, mit täglich neuen Inputs, mehreren Stakeholdern und sich verschiebenden Anforderungen. Wer Agentic Workflows baut, muss heute noch Supervision einplanen. Ohne Mensch im Loop fällt der Agent irgendwann aus dem Kontext. Das deckt sich exakt mit meiner eigenen Briefing-Erfahrung oben.
Self-Improvement bei 22%. Heißt: Die Modelle verbessern sich derzeit nicht messbar selbst. Der Recursive-Self-Improvement-Loop, der in Doomer-Szenarien als “Foom” bezeichnet wird, ist nicht produktiv deployed. Erste Komponenten existieren in Forschungssettings, AlphaEvolve und evolutionäre Code-Generation, aber kein System schraubt sich produktiv selbst hoch.
Operative Konsequenz für 18-Monats-Roadmaps: Mit Long-Horizon-Sprüngen rechnen, aber nicht auf einen Recursive-Loop-Sprung wetten. Das wäre der Punkt, an dem AGI kippt, und der ist noch nicht gemessen.
Lessons aus dem ersten öffentlichen Astro-Projekt
Auf der Bau-Seite ein paar Erkenntnisse, die für andere Astro- oder Three.js-Projekte nützlich sein könnten. Wie gesagt, das war meine erste Astro-Site im vollen Scope mit Content-Collections, Routing, Sitemap und allem drum herum.
Astro 5 ist für solche Content-Sites die richtige Wahl. Static Generation, Markdown-Content-Collections, Islands-Architecture wo Interaktivität gebraucht wird. Build-Zeit im einstelligen Sekundenbereich, Lighthouse-Score bleibt grün ohne Tricks. Wer React kennt, kommt in zwei Tagen rein.
Three.js für die AI-Brain-Visualisierung im Hero war der Teil mit der steilsten Lernkurve. Im Endeffekt eine animierte Punkt-Wolke mit Neuron-Verbindungen, GSAP-getriggered. Empfehlung: mit einem fertigen R3F-Beispiel starten und rückwärts engineeren, statt von Null bei Three.js Vanilla anzufangen.
GSAP für Scroll-Animationen habe ich vorher unterschätzt. Wer einmal mit ScrollTrigger gearbeitet hat, will nicht zurück zu reinen CSS-Keyframes für komplexe Sequenzen. Lizenzkosten sind für ein Projekt dieser Größe okay.
Datenhaltung: Briefings, Score-Updates und Dashboard-Werte liegen als strukturiertes Markdown vor. Das macht die Site auch ohne Datenbank wartbar und macht den Diff im Git-Repo zum Quartals-Update offen lesbar. Wer eine Annahme prüfen will, findet sie als YAML-Frontmatter im Source. Zusammen mit dem Claude-Code-PR-Workflow ergibt sich eine Update-Kette, die voll nachvollziehbar bleibt: Vorschlag → Diff → Approval → Merge → Deploy.
Schluss
Zurück zum Mai-Abend. Eine ungenutzte Domain, drei Wochen Arbeit, eine Seite die seit Mai online ist und jetzt im Juni hier dokumentiert wird. Sie ist kein Manifest, keine Prognose, kein Investment-Pitch. Sie ist ein Notizbuch über die wichtigste Technologie-Diskussion unserer Zeit, geführt aus der Perspektive eines IT-Leiters, der versucht trocken mitzuschreiben was passiert.
Wer reinschauen will: agi.jetzt. Dashboard direkt unter agi.jetzt/dashboard, Briefing-Archiv unter agi.jetzt/briefing. Source liegt auf GitHub. Wer einen Fehler findet, kann ein Issue aufmachen. Wer das Briefing abonnieren will, nimmt den RSS-Feed. Kein Newsletter, keine Schranke.
Eine offene Frage habe ich für mich selbst noch nicht beantwortet: wie sehr soll ich den AGI-Begriff selbst kritisieren. Der Score misst Annäherung an “AGI”, aber das Konzept ist umstritten. In einem der nächsten Briefings will ich die Definitionsdebatte aufmachen, von Shane Legg über OpenAIs Five-Level-Framework bis zu Yann LeCuns Position, dass aktuelle LLM-Architekturen prinzipiell nicht zu AGI führen können. Bis dahin lebt die Seite mit der pragmatischen Definition: AGI ist das, wo die acht Benchmarks zusammen über 95% Gap haben. Nicht perfekt, aber messbar. Und messbar ist der einzige Boden, auf dem man eine ehrliche Diskussion führen kann.